本篇的判断是:器官蛋白时钟具有研究与风险预测价值,但器官来源、年龄尺度和干预响应仍需分别验证。 我们核对公开模型系数与原始补充表,并建立参照人群、多指标阈值和蛋白释放—清除模型,考察这些读数如何形成、又可能如何被误读。
“器官年龄”这个数字怎样产生
2023年Oh等人的研究先利用GTEx组织RNA资料,把某器官中表达至少为其他任一器官四倍的基因标记为“器官富集”,再映射到血浆蛋白测量项。来自同一器官的富集蛋白,被用于训练预测出生年龄的模型。原始研究
这一过程使用了生物学信息,但训练目标仍然是出生年龄。它没有把心脏泵血能力、肾脏滤过能力或脑组织病理的“真实年龄”作为已知答案。2023年主要模型从1,398名认知未受损者训练,再到其他队列检验;2025年的Olink版本则在英国生物样本库重新训练。2023年原表 2025年研究
在LASSO线性模型中,预测年龄由截距和各蛋白标准化读数的加权和构成;2023年版本还包括性别项。后续的“年龄差”通常又减去了同龄人的预期预测值,并除以相应的标准差。因此,论文中的年龄差不总是“预测年龄直接减去出生年龄”,一个标准差也不具有跨模型固定不变的年数。
| 层次 | 实际检验的问题 | 仍需额外回答的问题 |
|---|---|---|
| 预测出生年龄 | 蛋白模式能否区分不同年龄的人 | 是否对应器官功能或疾病过程 |
| 相对年龄差 | 同龄人中,谁的模型读数更高或更低 | 更换参照人群后是否仍可比较 |
| 预测未来疾病 | 读数是否与后来的结局有关 | 是否改善校准、决策和临床获益 |
| 干预响应 | 治疗后读数是否改变 | 这种变化能否可靠代表健康改善 |
先核模型实际用了什么
我们将2023年SomaScan和2025年Olink版本的公开系数,与各自的蛋白注释及候选输入逐项对应。它们虽然使用相似的器官标签,实际保留下来的测量项却可能很不同。系数原表 Olink系数及方法
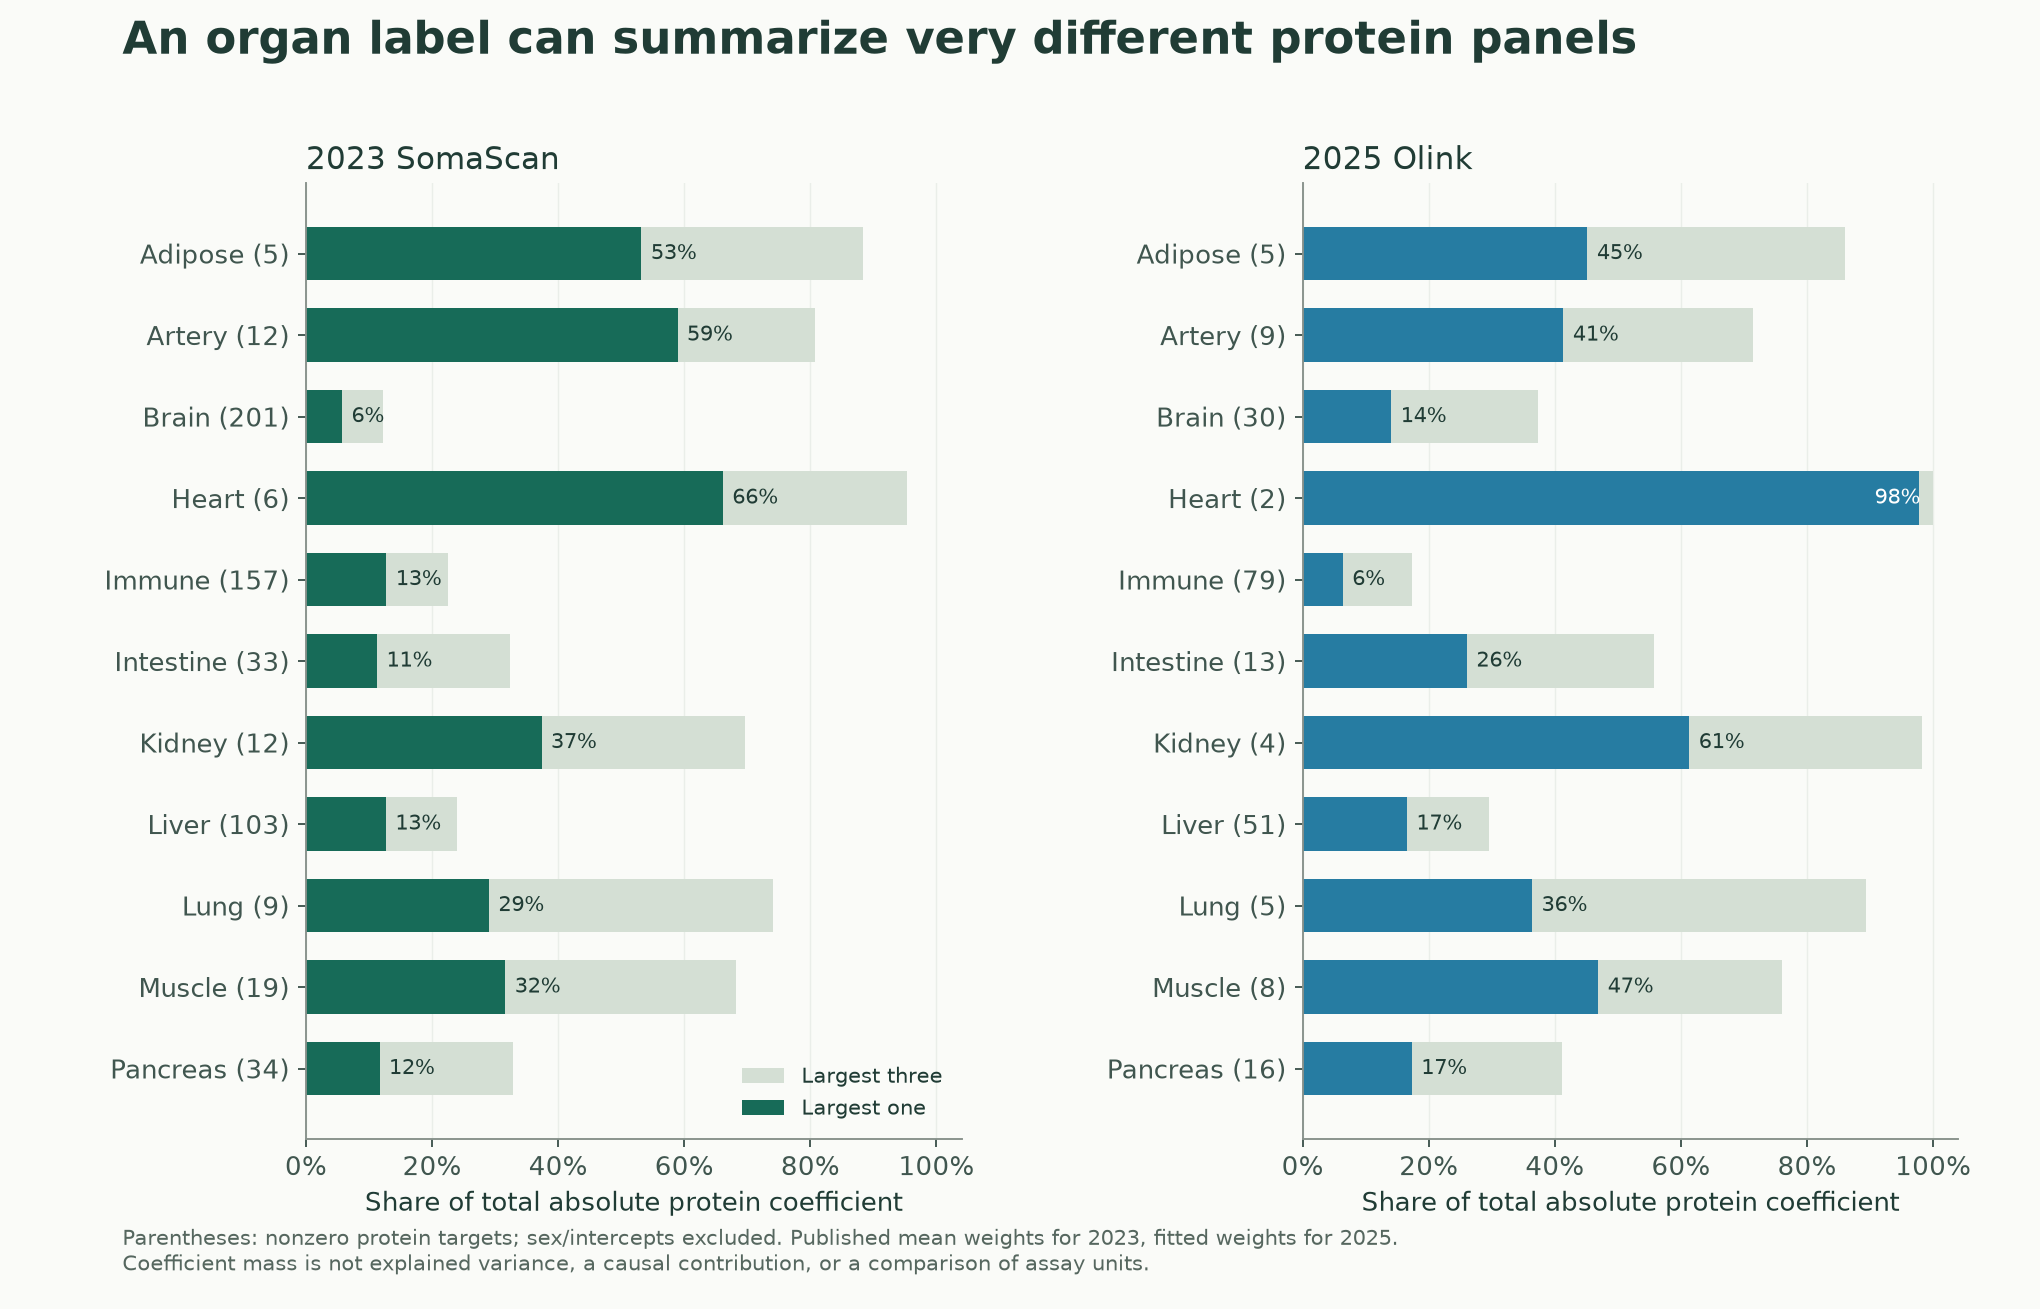
例如,按2023年集成模型的平均系数统计,心脏有6个非零蛋白测量项;2025年版本只有2个,其中NPPB对应的NT-proBNP测量项占绝对蛋白系数总和约97.8%。2025年肾脏模型有4项,REN约占61.3%。年龄训练的脑模型则分别有201项和30项;2023年的数量不代表每个自助抽样子模型都用了相同的全部蛋白;论文另有经过认知目标筛选的脑模型,不能混为同一个时钟。
这里的比例只是我们根据标准化系数计算的权重集中程度,不是解释了多少器官衰老,也不是解释方差的百分比。相关蛋白之间可能共享信息,测量噪声和不同平台的标准化也会影响系数。
NT-proBNP本身与心脏负荷和临床心脏状态有关。它在模型中占很大权重,可以使模型捕捉有用的心脏风险信息,却不能仅凭“心脏年龄”这个名字,把读数理解成心脏全部功能的综合测量。
注释还有一层细节:部分测量对象是蛋白复合物,其组分的富集标注并不完全一致。我们逐组分核对了匹配关系,没有把一个复合物的器官标签当作每个组分都只有一个来源。
同一份样本,为什么会随参照人群改变
原始2023年分析按队列计算相对年龄差;公开软件默认采用训练队列的标准化和参照曲线,并提供重新按目标队列校准的方法。2025年作者的应用示例则对目标数据进行蛋白标准化,并根据普通人群或对照组拟合年龄参照。SomaScan软件 Olink应用示例
固定参照方便跟踪同一尺度,但需要处理平台和批次差异。按新队列重新校准可以去掉部分技术偏移,也可能同时去掉真实的人群差异。这是不同测量问题,需要在报告读数时交代。
我们用2025年心脏模型的真实权重构造了一个假设例子:两组人的年龄分布相同,第二组的两个蛋白读数都比基线高1.5个标准差;蛋白与年龄的联系、组内波动均按明确的假设设定。观察对象始终保持同一份蛋白读数,变化的只是参照人群中第二组的比例。
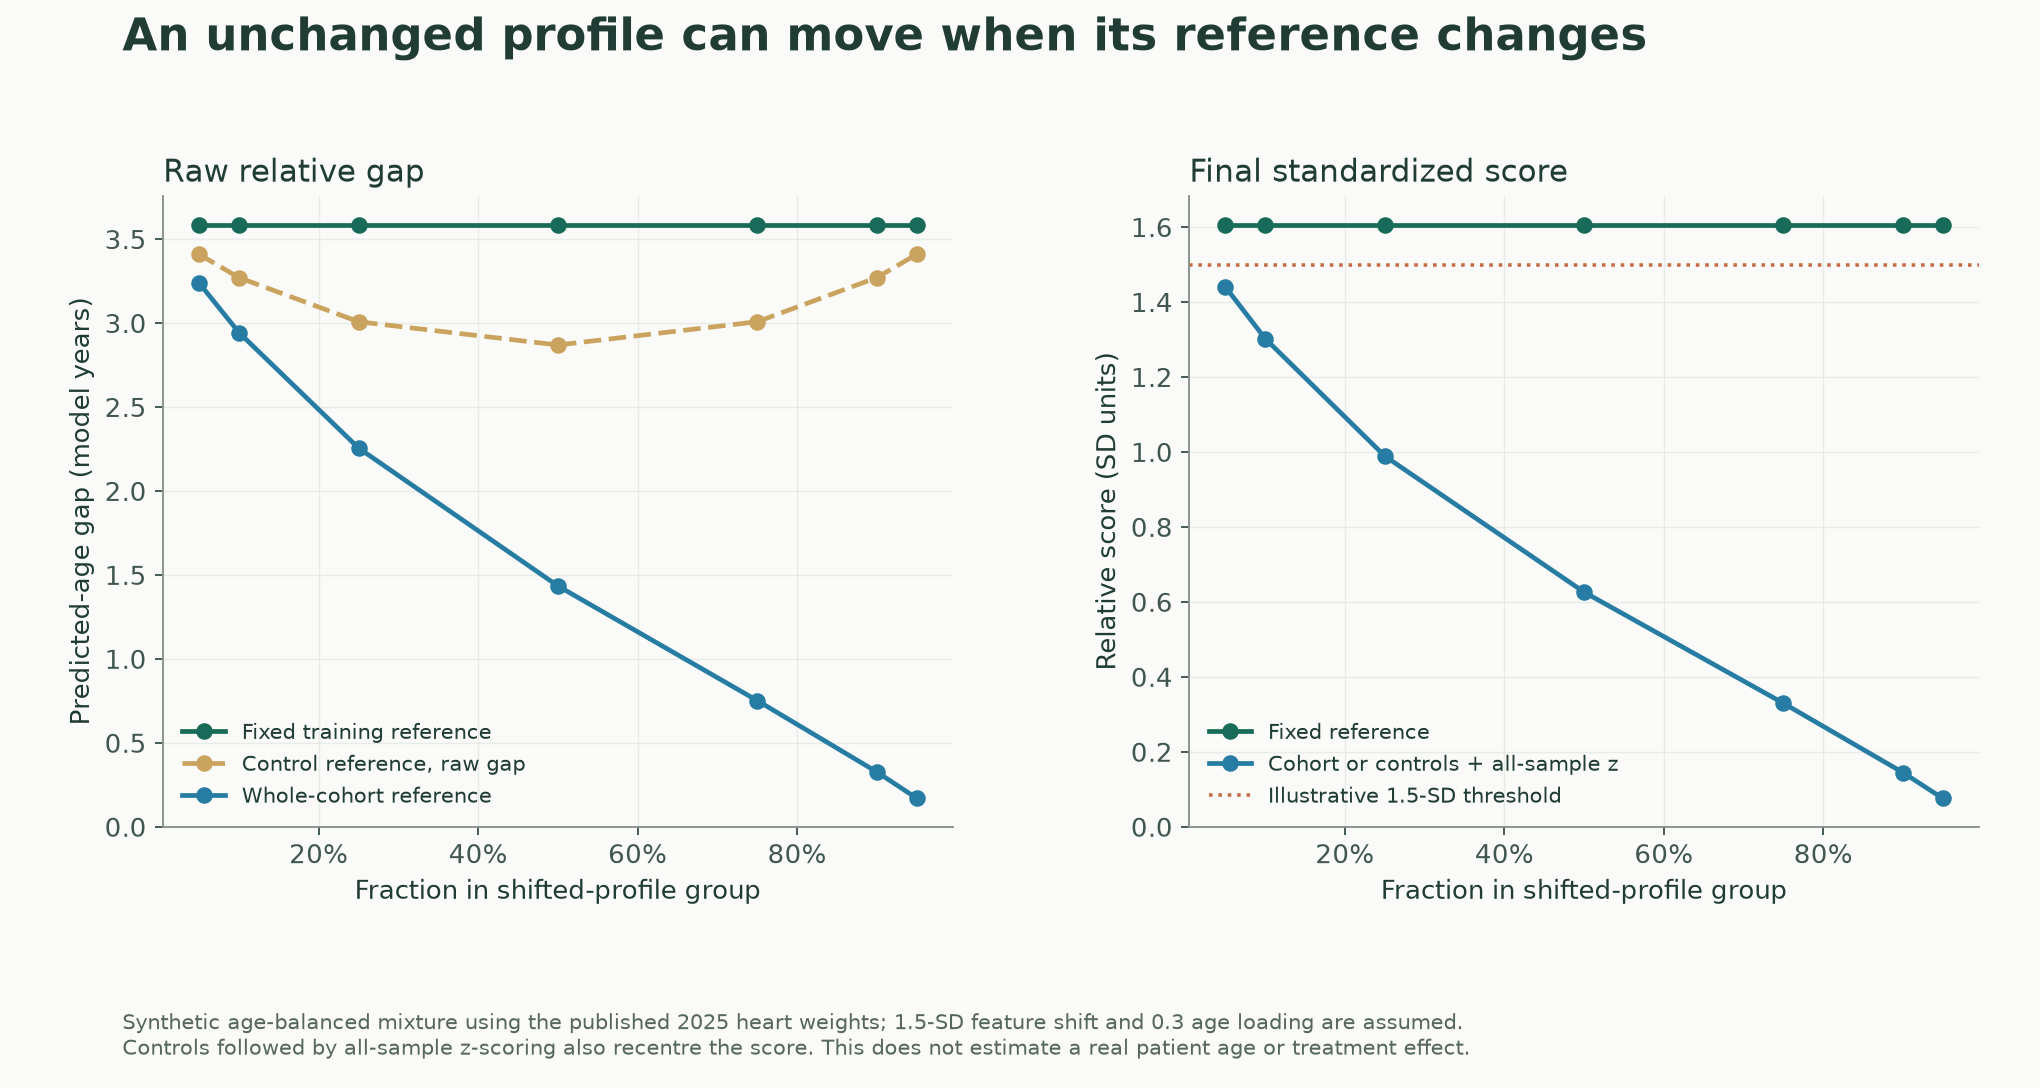
在固定训练参照下,该样本的标准化分数约为1.61。若按整个目标人群重新计算,当第二组占5%、50%和90%时,该样本的分数分别约为1.44、0.63和0.14。模型里这个样本没有发生任何变化。
一个容易忽略的步骤是:先用对照组建立原始年龄差,如果最后又对全部样本做一次均值为零的标准化,仍会重新引入全体人群的中心。在我们的年龄平衡例子中,两种路径得到相同的最终标准化分数。
这些数字不是患者结果,也不是对某种疾病的拟合。它们说明,个人读数的比较需要固定模型版本、预处理和参照规则;否则,“少了几年”可能包含标尺本身的变化。
一次看多个器官,尾部标签本来就会增多
把一个分数超过1.5或2个标准差的人标为“极端衰老”,首先是一种分布定义。它不是由该阈值本身验证的临床诊断。
作为最简单的参照,若11个分数相互独立且服从标准正态分布,至少有一个分数超过正向2个标准差的概率约为22%。这不要求另加一个特殊的“单器官快速衰老”人群。
我们还使用2025年研究公开的年龄差相关矩阵,建立了保留相关结构、但假设各分数具有正态边际分布的参照模型。按照该论文的分类范围,纳入11个器官加上Organismal总体分数,共12项;每种设置模拟30万个个体。相关矩阵与阈值定义
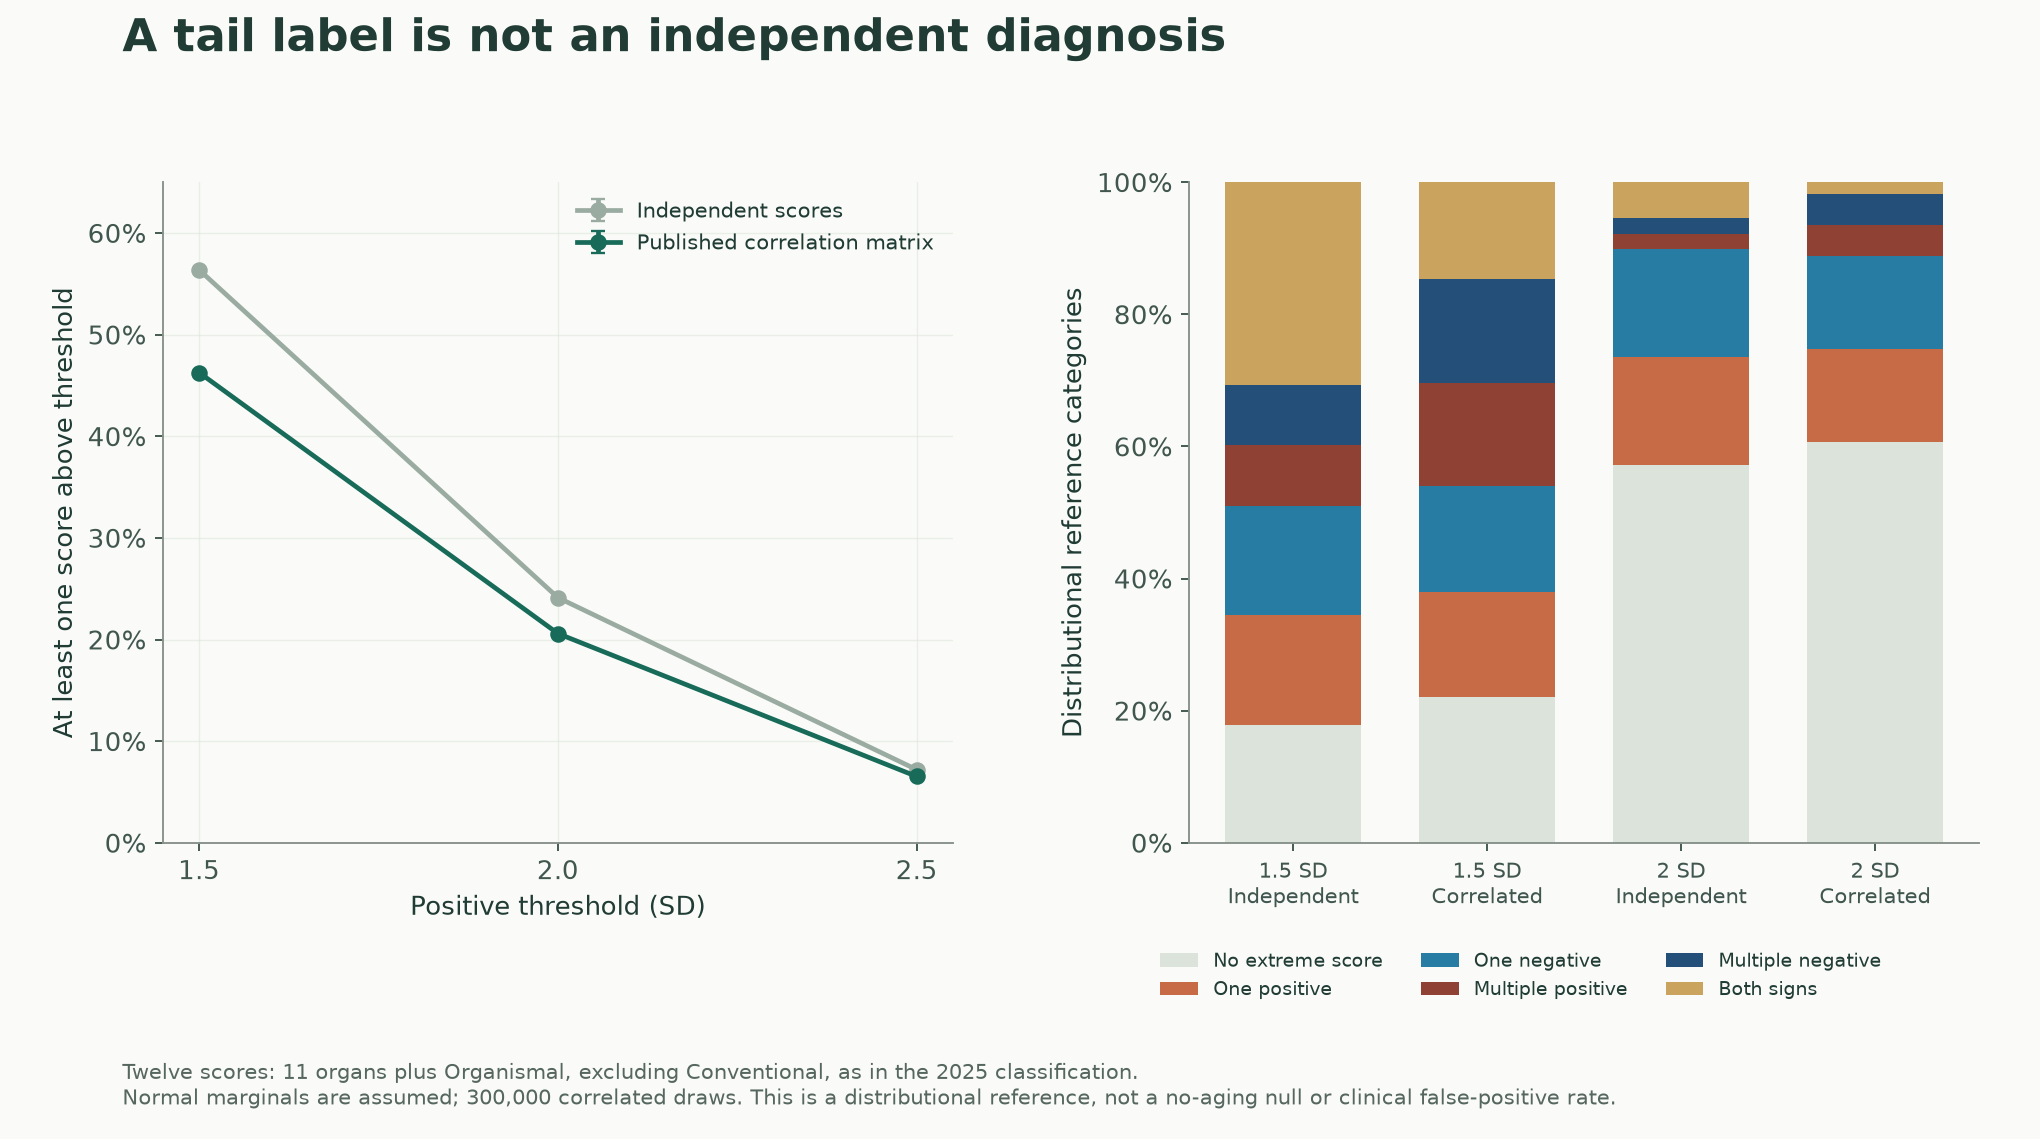
在1.5标准差阈值下,这个参照模型约有46%出现至少一个正向极端分数,约78%出现至少一个正向或负向极端分数。提高阈值或改变指标间的相关性,比例就会改变。
这不是对真实人群误诊率的估计,也不是证明器官衰老不存在。 正态边际只是本篇假设,真实分布可能偏斜;该计算也没有复现2023年论文的聚类分型。它只说明,标签出现的比例不能脱离指标数量、阈值和相关结构解释。标签是否有健康意义,还要看独立的功能和结局证据。
从组织来源到血液读数,中间还有释放与清除
RNA在某个器官富集,是蛋白来源的有用线索,但它没有直接测出血液中每个分子从哪里来。蛋白可能被主动分泌、保留在组织局部,也可能随细胞损伤、更新或屏障变化进入血液。分泌蛋白图谱本身就区分了这些不同去向。人类分泌蛋白组
2025年研究也将RNA富集注释与组织蛋白组进行比较:约80%的相关蛋白在相同器官得到相符归类,另有部分属于其他器官富集或非富集类别。组织内表达、蛋白最终分布和血浆中实际来源并不是同一次测量。实际方法与补充图
为说明最基本的可识别性问题,我们建立一个单室模型:血浆浓度的变化等于输入速率减去清除速率常数乘以当前浓度。在体积固定、参数恒定的条件下,稳态浓度为输入速率除以清除速率常数。
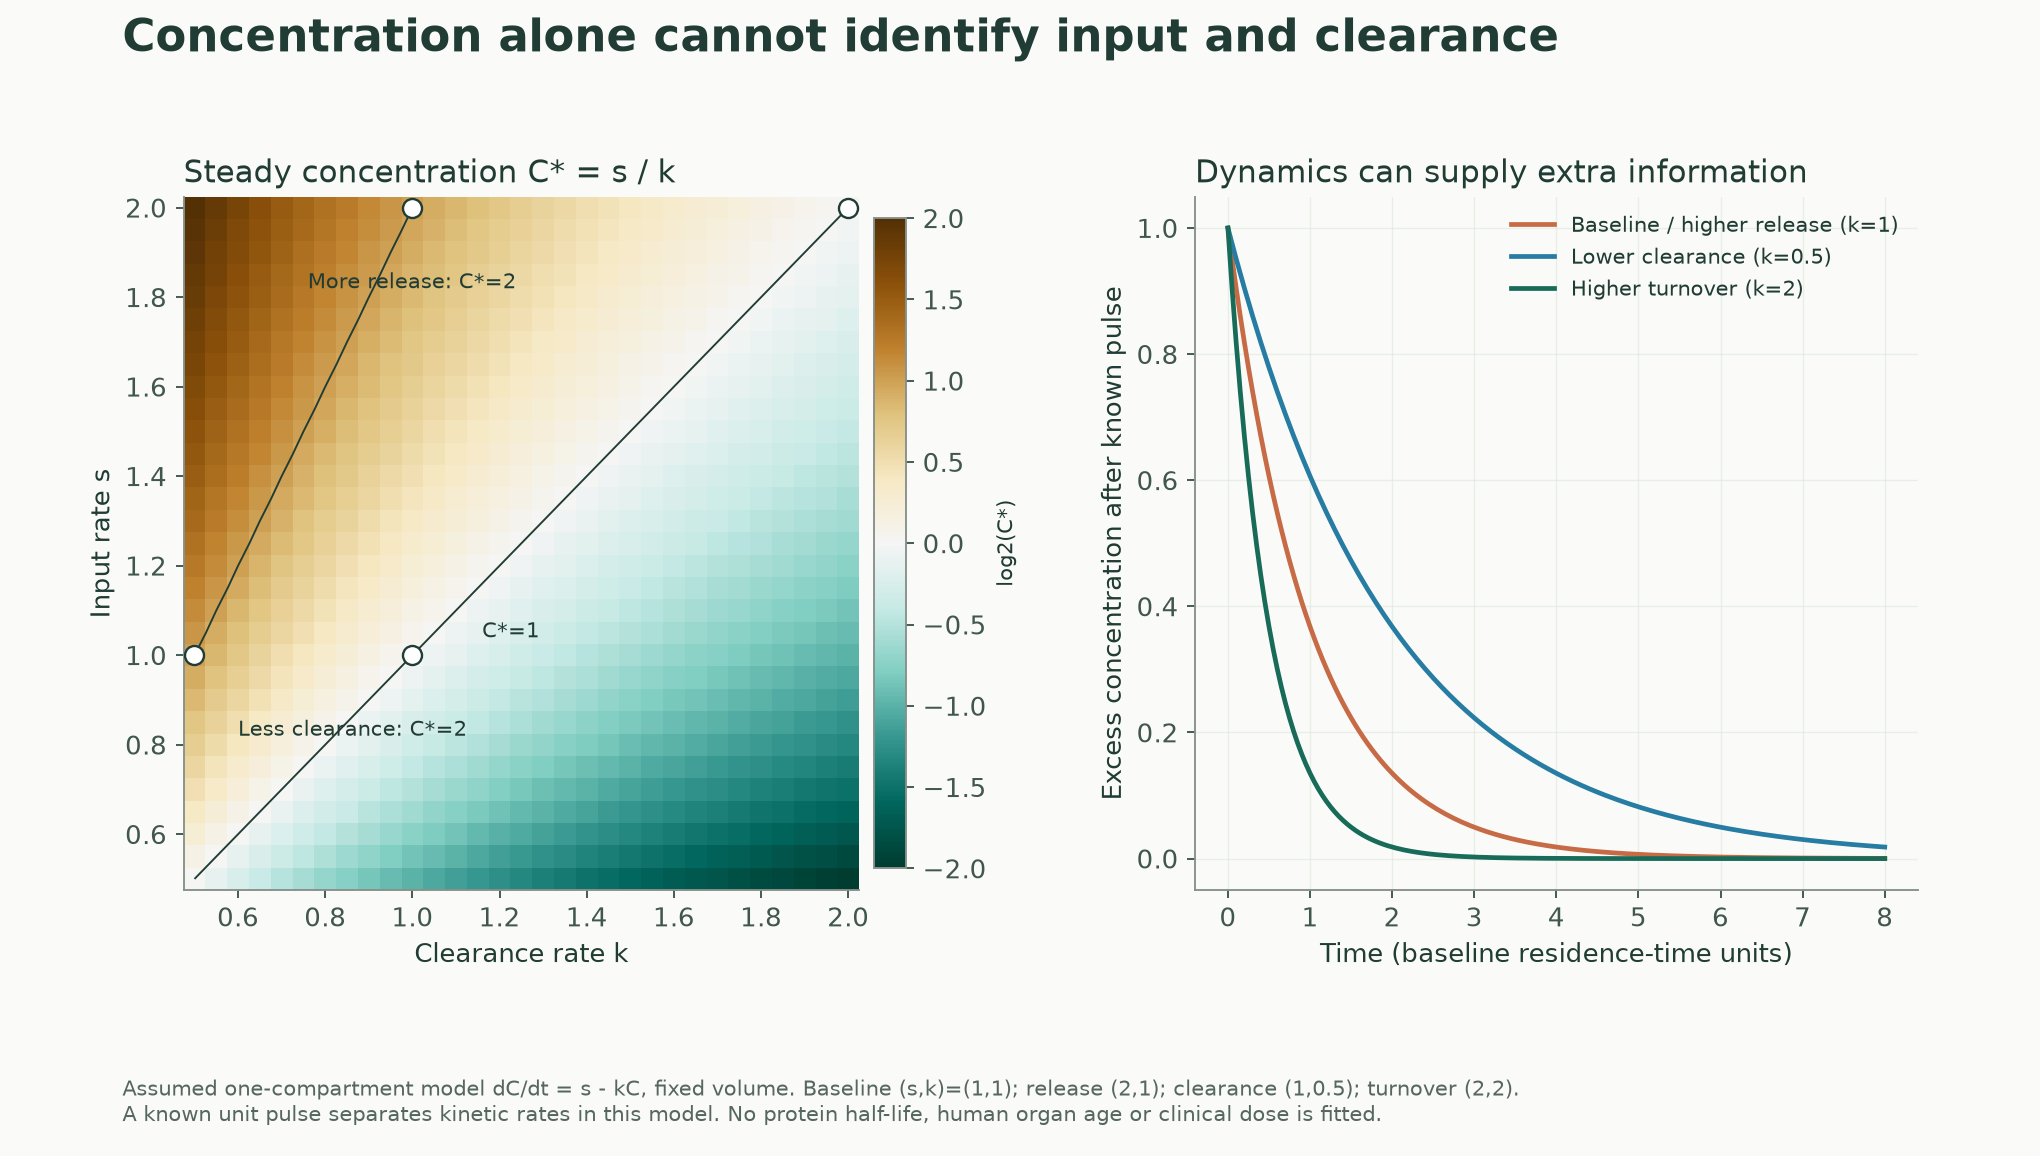
于是,输入增加一倍和清除速率减半,都能使稳态浓度加倍;输入与清除同时增加一倍,浓度又可以保持不变。只看到一次相同的浓度,就无法区分这些过程。假设能给出已知的输入脉冲并测量随后的变化,才可能获得额外的动力学信息。
这里的速率和时间单位都是假设,未拟合任何人体蛋白的半衰期。模型也没有证明现实中的某个时钟“主要由清除造成”。
实际证据同样需要保留两面:血浆NfL与肾功能指标有关,但一项同时考察血液、脑脊液或脑影像的研究发现,调整肌酐并没有明显改变NfL与神经退行性指标的关联。清除是需要检验的机制解释,不能单凭相关性认定;肾功能也可能与真实疾病过程有关。NfL与肾功能研究
跨人群验证,究竟验证了什么
Wang等人的另一套模型使用LightGBM,在英国生物样本库训练,并到中国CKB和美国NHS检验。它提供了重要的跨人群证据,但使用的蛋白选择、算法和校准方式与上述LASSO时钟不同。跨人群研究及原表
我们重算其公开表中的“模型表现之间的相关性”:英国与中国约为0.975,英国与美国约为0.959,中国与美国约为0.928。这是在11个模型的表现之间进行相关计算,不能读成每个器官对个人年龄的预测都有接近98%的准确度。
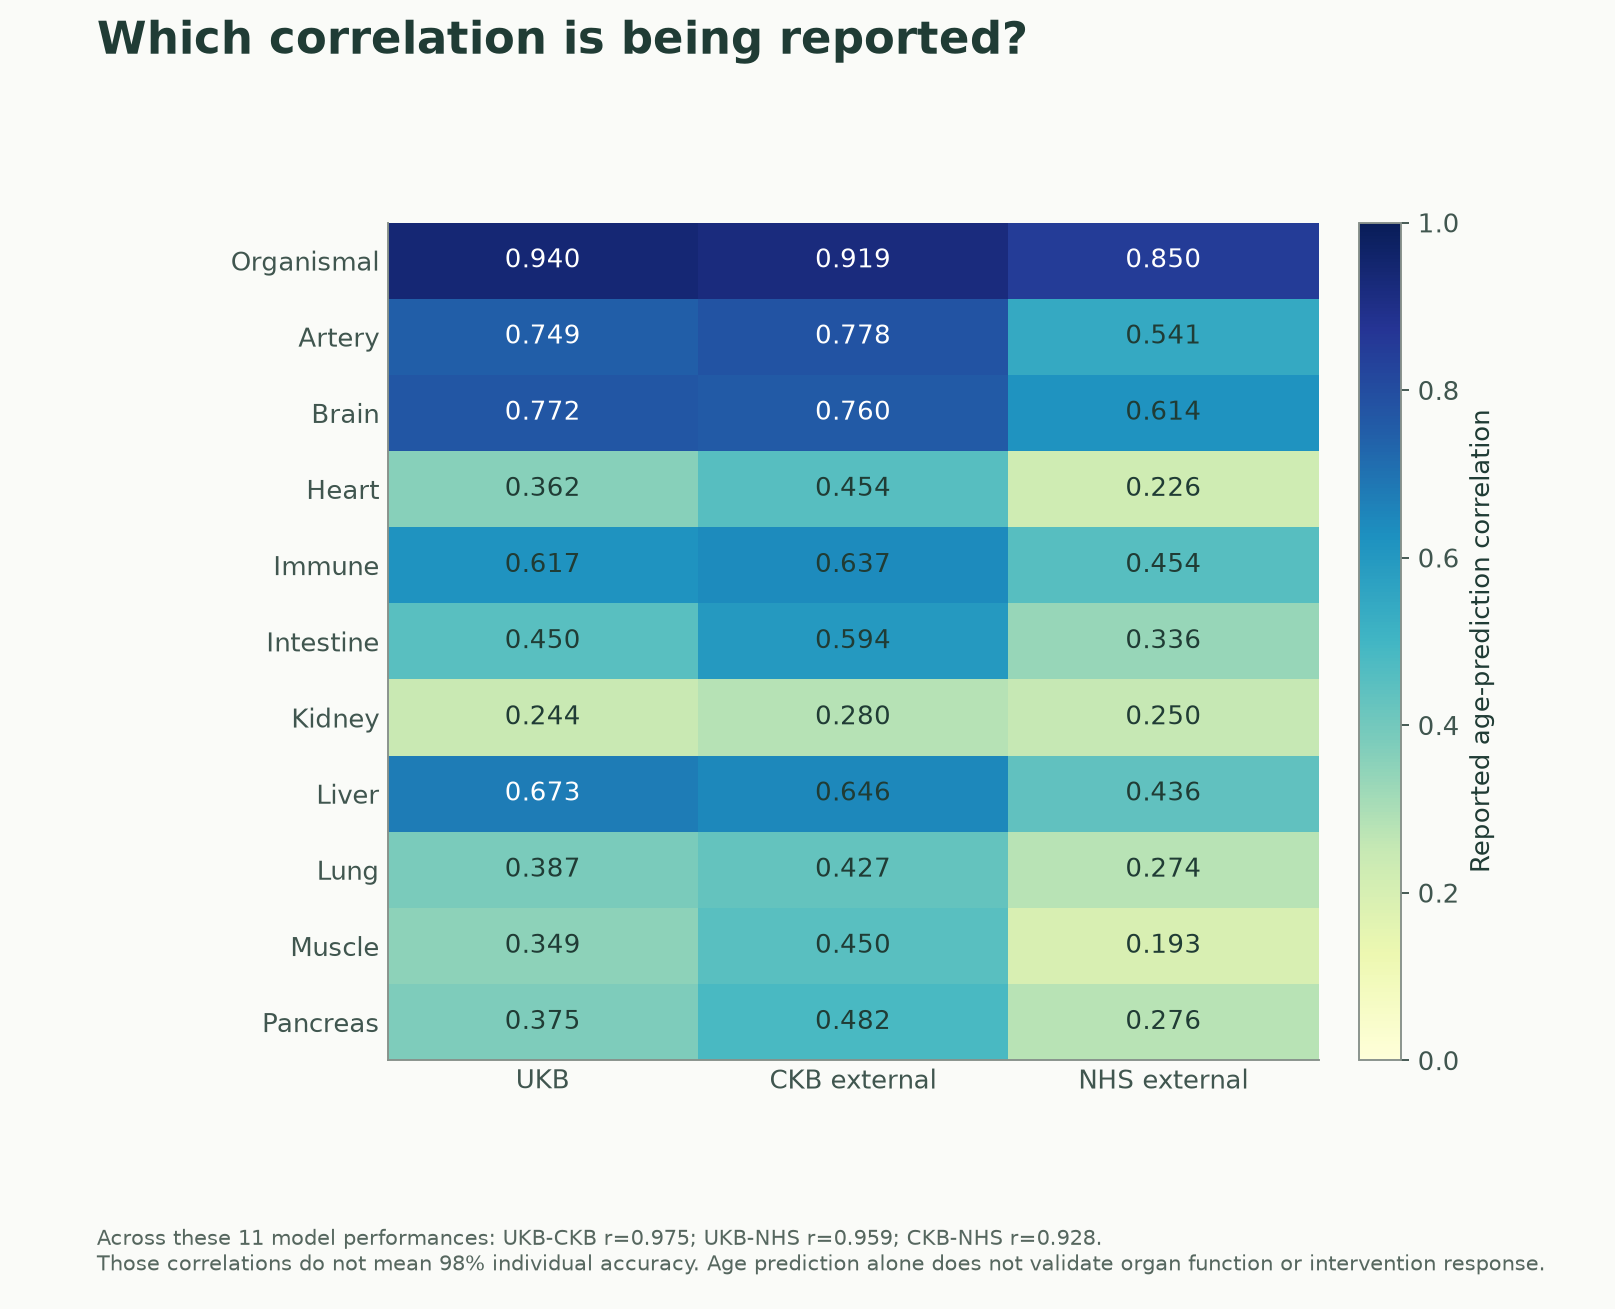
逐个模型看,脑模型在三个人群中的出生年龄相关系数约为0.772、0.760和0.614;心脏模型约为0.362、0.454和0.226。相关性还会受年龄范围影响:即使预测噪声完全相同,在年龄跨度更大的人群中也可能得到更高的相关系数。
这些外部样本也不是三份完全相同的普通人群调查。CKB验证样本来自缺血性心脏病的病例—子队列设计;NHS样本来自结肠癌研究的嵌套抽样,参与者全部为女性。跨人群结果有价值,仍需区分年龄预测、绝对校准以及临床风险在不同人群中的迁移。
疾病预测有支持,也有未重复的结果
不同研究使用相似名称,不代表它们提供的是完全独立、完全同义的重复验证。
| 研究 | 提供的主要信息 | 解读时的关键区别 |
|---|---|---|
| 2023年SomaScan研究 | 器官蛋白年龄与疾病、功能和后续结局的关联 | 年龄训练模型与认知优化模型分开 |
| 2025年Olink研究 | 约4.45万人中的疾病和死亡关联,以及跨平台、纵向分析 | 与2023年模型的蛋白和训练过程不同 |
| Wang等跨人群研究 | UKB、CKB、NHS中的年龄预测及结局关联 | 使用不同算法;部分人群与其他论文共享 |
| 2026年EPIC研究 | 用既有SomaScan模型检验长期疾病与死亡结局 | 中年病例—子队列设计;并非复算2025年Olink模型 |
2025年Olink研究发现脑与免疫分数对部分结局有较强预测意义,也发现跨平台的器官年龄差只有中等至较强的一致性。纵向分析需要另外训练覆盖较少蛋白的模型;首次被标为极端者,约68%在后一次测量中不再达到同一极端阈值。技术变化、真实变化和回归均值都可能参与,不能直接把退出极端类别叫作器官年轻化。Olink研究
2026年EPIC研究分析了17,473名参与者的资料,采用病例—子队列设计并按设计加权。它支持器官分数与某些相应疾病及死亡的关联,却没有在所用的2023年SomaScan脑模型中重复出对神经退行性结局的清晰预测。平台、模型版本、入组年龄、结局和随访时间都可能参与这种差异;当前资料不能把原因归给其中一个因素。EPIC正式报告
这也意味着,“脑年龄在所有独立研究中都最有预测价值”不是一个稳妥的总判断。
预测增加多少,与临床有益仍是两道问题
EPIC还比较了死亡风险模型的区分能力。我们按实际图源表复算:在包含年龄、性别、中心和生活方式风险因素的模型基础上,加入Global综合蛋白年龄差,一致性指数从约0.730升至0.739;加入全部器官及Organismal分数后约为0.743。原始图源及方法
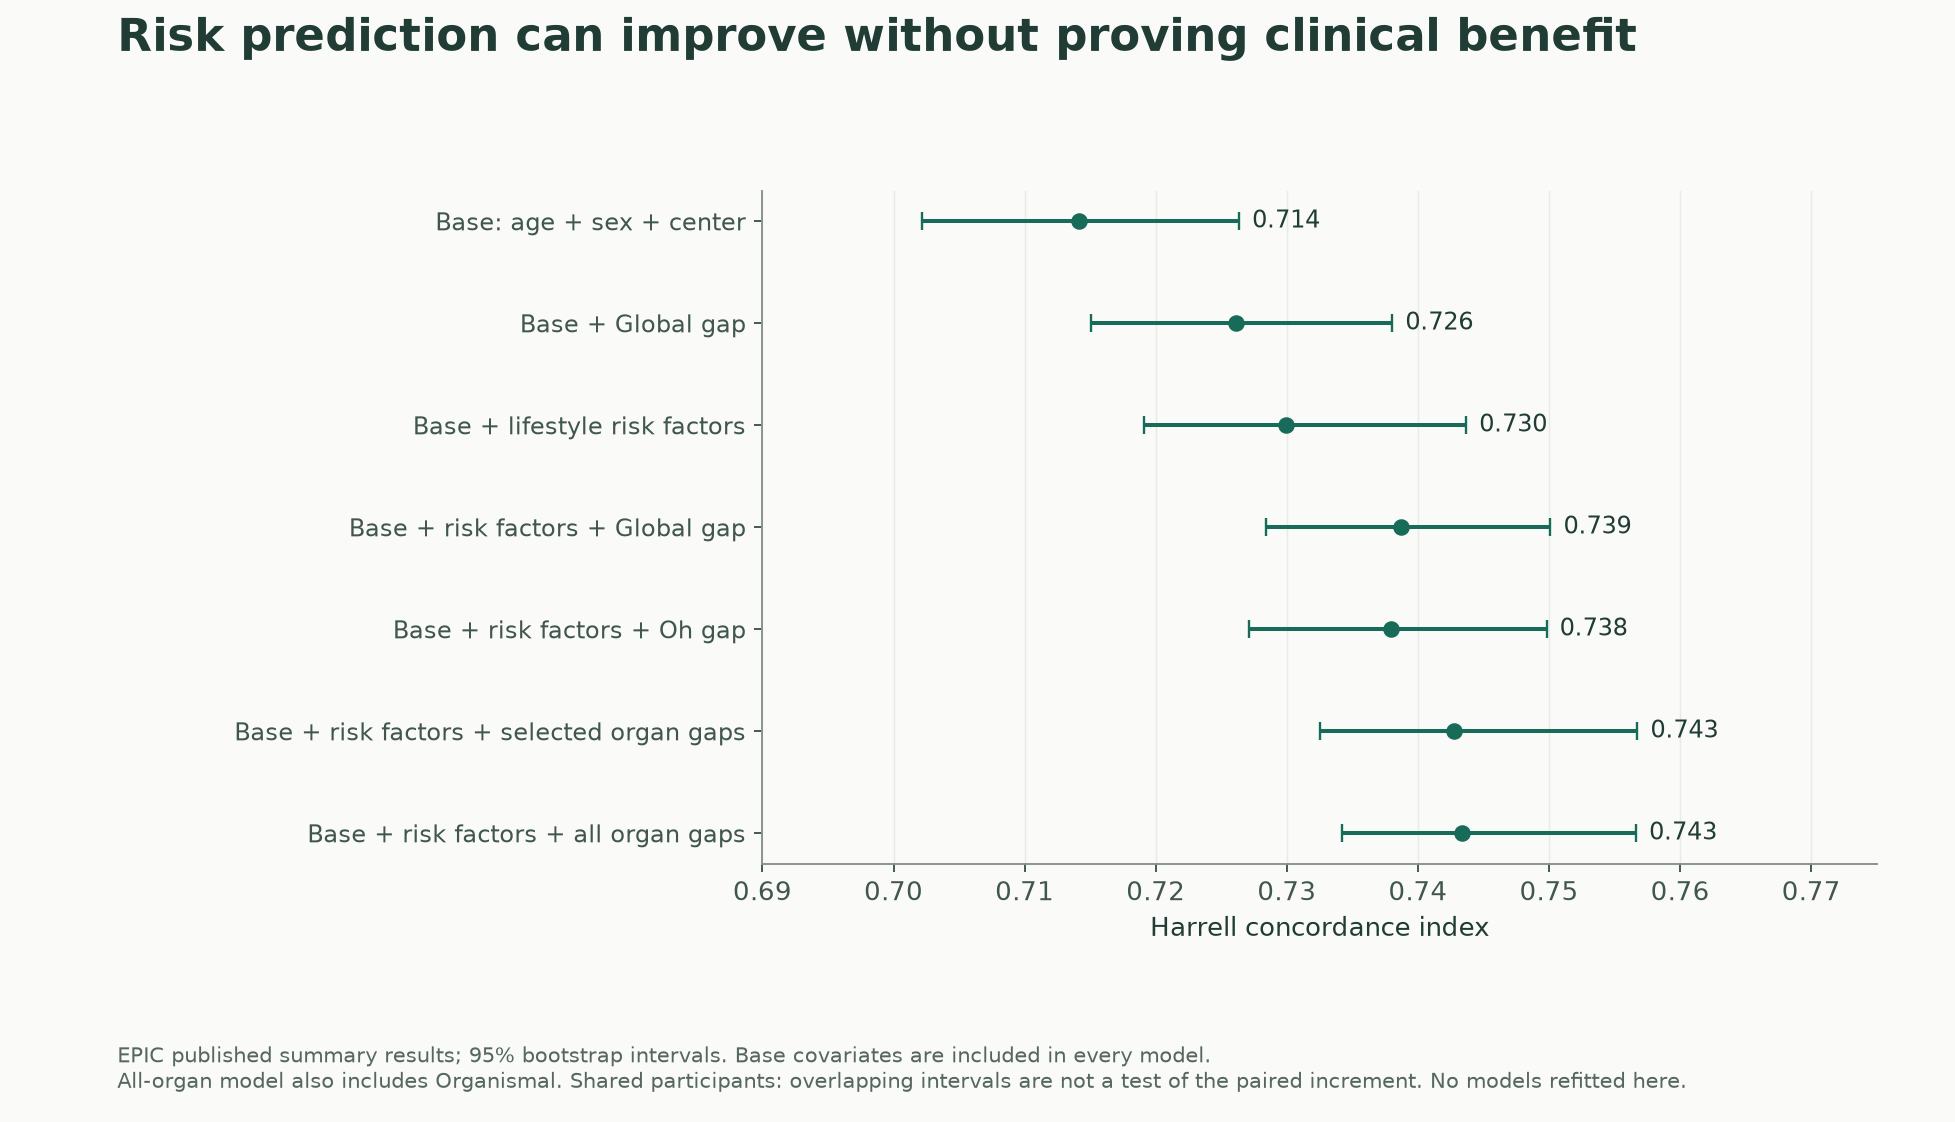
后一个增量约为0.0135。它描述的是模型对结局顺序的区分能力,不是减少了1.35%的死亡。图中保留作者报告的bootstrap区间;由于这些模型共享参与者,不能用两条区间是否重叠来代替对差值的配对检验。
本篇没有取得可直接重跑的受试者矩阵,也没有重做病例—子队列加权、模型拟合或作者bootstrap。公开汇总表可以支持数值核对,却不能让我们独立验证校准、临床阈值或决策净收益。即使模型有统计增量,也还需要研究它是否改变了正确的临床决策,并最终改善结局。
细化到细胞类型,不会自动消除上述边界
2026年Ding等人的研究进一步用细胞类型富集蛋白构建时钟,并在SomaScan、Olink及多个队列中考察疾病与死亡。它把问题推进到更细的细胞层级,但仍主要借助RNA富集来命名模型。细胞类型研究
作者明确指出,一些被赋予特定细胞标签的蛋白可能在其他情况下由更广泛的来源产生或释放。部分结局关联在调整肾功能后仍然存在,因此也不能把全部信号归为清除因素。与此同时,使用既有Knight-ADRC和UKB人群的部分分析,不能被当成完全新增的独立人群重复。
正如免疫多样性篇中序列数和功能测量需要额外连接一样,更细的蛋白标签也需要与真实来源、组织功能和临床结局建立可验证的联系。
这些读数目前最适合回答什么
器官蛋白时钟适合研究人群之间的异质性、提出机制假说,并探索能否补充已有风险模型。它们已经不只是毫无结局依据的年龄拟合,但也还不能被当作所有器官共用的一把生理年龄尺。
下一步最有区分力的研究,应在固定版本和参照规则下,加入重复采样、器官功能或组织测量,并把临床预测模型放到真正独立的人群中检验。对于干预研究,还需验证干预引起的分数变化能否可靠预测临床结局,以及是否存在改变分数却不改善健康的路径。
本篇的原表审计和条件模型解释了读数怎样形成、哪些过程可能无法从单次血样分开;没有恢复任何人的真实器官年龄,也没有估计延寿效果。
适用范围与限制
- 本篇重算公开系数、注释与图源汇总,没有受试者矩阵,不声称外部患者重分析、模型再训练或临床校准。
- RNA富集及复合物组分匹配只核注释自洽,未直接追踪血浆分子来源或测量器官功能。
- 各论文有平台/队列复用、选择与终点差异;SomaScan脑预测未重复不直接推翻另一Olink模型。
- 参考人群、正态尾部和动力学参数是假设;结果不代表临床误诊率、真实患者年龄或人体蛋白半衰期。
- 2023为平均系数,2025单一拟合系数;份额不等于方差解释。训练示例r标签、部分原表口径及EPIC SE/CI差别保留,不猜修。
- 作者结果和CI未从原始个体数据重做,不能补出配对增量CI、绝对风险、决策净收益或干预替代性。
- 旧稿影像/代谢/GWAS/LLM/HIV及动物分支未全面重审;Whitehall/Wen完整主文未取得,部分最新旁支只筛摘要。
- 研究、计算、自审、翻译与编辑均由同一Codex agent完成,非独立人类专业审核。
参考来源
- Oh et al. Organ aging signatures in the plasma proteome track health and disease. Nature (2023)
paper · 来源版本: 2023
实际读取范围
相关章节
读器官富集、原年龄训练/认知优化区分、临床关联、讨论及训练/LOWESS方法和利益披露;未把训练出生年龄写成直接测功能。正文与附表部分队列人数口径不一,不据此拼接参与者总数。
- Organ-enrichment Results; organ disease Results; Discussion
- Methods: identification, bagged LASSO and age-gap calculation
- Oh et al. Original supplementary tables: annotations, model coefficients and performance (2023)
supplement · 来源版本: 2023 supplementary XLSX
实际读取范围
相关章节
实际核ST3/5/7/8的注释、候选表、平均系数与性能;ST11/12相关汇总保留。ST6的500个模型未逐一重拟合;性别项与蛋白项分开,复合物按组分核读。
- ST3, ST5, ST7, ST8; selected ST11–12 cells
- Oh: organage software, fixed training references and optional cohort recalibration
software · 来源版本: commit 59303fd / read 2026-09-20
实际读取范围
相关章节
锁提交59303fd0dccc191be1ff34bf0bbf5efd8b90387a,读OrganAge.py完整及预测示例,核normalize/setup/LOWESS/zscore和可选目标队列校正。训练notebook只核相关路径,未执行模型pickle,也未对真人调用。
- OrganAge.py: normalize, setup_input_dataframe, calculate_lowess_yhat_and_agegap, zscore_agegaps
- Predict organage example: cohort recalibration
- Oh et al. Plasma proteomics links brain and immune system aging with healthspan and longevity. Nature Medicine (2025)
paper and supplement · 来源版本: 2025
实际读取范围
相关章节
读主要结果/方法/讨论及实际补充图1–4说明、ST2–5与相关结局表;核中心分割、全数据标准化/插补、同名跨平台差异、1.5k纵向代理及68%退出极端类别。权重集中度不当解释方差,RNA/组织蛋白80%相符非直接血浆来源追踪。
- Results: model derivation, cross-platform/longitudinal checks
- Methods: QC, enrichment, age estimation; Supplementary ST2–5, ST6/11–12
- Oh: organageUKB training and application tutorials
software · 来源版本: commit b49aa38 / read 2026-09-20
实际读取范围
相关章节
锁提交b49aa385835f19d374d94a37410da1550d655905,读两本notebook的源代码。目标队列蛋白zscore、对照/总体参照及全样本agegapz分别核;训练例的r由sqrt(R²)生成,保留表标签而不声称重算Pearson。缺少原队列矩阵未跑作者全训练。
- Github_tutorial.ipynb: prediction and agegapz
- UKB_Olink_3k_aging_model_github.ipynb: training and resstat
- Wang et al. Organ-specific proteomic aging clocks predict disease and longevity across diverse populations. Nature Aging (online 2025; issue 2026)
paper and supplement · 来源版本: 2025 online / 2026 issue
实际读取范围
相关章节
读模型/跨人群结果、临床预测段、讨论及方法;实际ST3–5和部分ST7/8/11、附录Notes5–7。确认CKB IHD病例—子队列、NHS结肠癌抽样且全女性;跨11模型表现相关不作个人98%准确率。核ROC函数相关glm/predict段,不声称重做所有临床/GWAS/LightGBM。 图5按ST5原表只标UKB,不额外假定该列仅为测试子集。
- Results: model performance and prediction comparison
- Methods; supplementary Notes5–7; ST3–5
- Organ-PAC Fig6.R, relevant fit/predict function
- Robinson et al. Associations of proteomic age clocks with lifestyle risk factors, incident chronic diseases and mortality in two European cohorts. Nature Aging (2026)
paper and supplement · 来源版本: 2026 final publication
实际读取范围
相关章节
读实际正式主文的设计、结局/讨论、加权Cox与concordance方法;附录S1/S4及图6实际XLSX。核年龄训练版本、脑预测未重复及病例—子队列限制。只重算图源差值/指数,CI原样保留;图6I的SE不直接重建所给CI,未用猜测替换,也未重跑加权/配对bootstrap。
- Results: organ models and mortality discrimination
- Methods: statistics and reproducibility
- Supplement TableS1/FigS4; Figure6 source values
- Ding et al. Plasma proteomic signatures of cellular aging predict human disease. Nature Medicine (2026)
paper · 来源版本: 2026
实际读取范围
相关章节
读主文相关结果、来源限制、细胞富集/训练/队列/PARS及稳定性方法、肾功能敏感性图注和利益披露。识别Knight-ADRC/UKB复用;部分组分来源并非独占。附表只筛结构,未重算细胞/风险模型或其完整补充结果。
- Relevant Results and Discussion
- Methods: cell enrichment, age estimation, cohorts, stability and PARS
- Renal-sensitivity captions; competing interests
- Tang et al. Association of neurofilament light chain with renal function: mechanisms and clinical implications. Alzheimer’s Research & Therapy (2022)
paper · 来源版本: 2022
实际读取范围
相关章节
读ADNI/VETSA对象、相关结果解释与讨论。肌酐调整后与CSF/MRI关联保留,清除与共享生物过程是不同解释;未将清除假说当已识别分子机制,未重算双生子模型或给个人校正建议。
- Methods: Study1/Study2
- Discussion: creatinine, CSF/MRI and clearance hypothesis
- Uhlén et al. The human secretome. Science Signaling (2019)
paper · 来源版本: 2019
实际读取范围
相关章节
读实际机构存档论文的摘要、引言及分泌去向框架(正文页1–2);区分血液分泌、局部保留与泄漏。未把整个检测血浆蛋白集都当主动分泌蛋白,未重做HPA全数据库。
- Main-text pages1–2: abstract, introduction and secretome localization
作者与实际审阅
作者自审 · Codex (AI agent)
2026-09-20 · 同一Codex作者自审:核实际原文/补充/公开代码的来源、训练目标、平均系数/单模型、参考与标准化、跨平台及队列复用、尾部定义、EPIC加权和增量解释、释放清除/肾功能反证;逐段核中英文和六图。纠正自身空字符串计数及复合物解析,细化平均系数非零数的含义;保留原表SE/CI与读取缺口,不猜修。4196源表单元格以独立XML解析核对;386项R/Python通过,26输出空目录重放一致。未取得个体矩阵,不声称临床重拟合/校准或独立人类审核。新旧网页验收单独记录。
仍有限制:
- 本篇重算公开系数、注释与图源汇总,没有受试者矩阵,不声称外部患者重分析、模型再训练或临床校准。
- RNA富集及复合物组分匹配只核注释自洽,未直接追踪血浆分子来源或测量器官功能。
- 各论文有平台/队列复用、选择与终点差异;SomaScan脑预测未重复不直接推翻另一Olink模型。
- 参考人群、正态尾部和动力学参数是假设;结果不代表临床误诊率、真实患者年龄或人体蛋白半衰期。
- 2023为平均系数,2025单一拟合系数;份额不等于方差解释。训练示例r标签、部分原表口径及EPIC SE/CI差别保留,不猜修。
- 作者结果和CI未从原始个体数据重做,不能补出配对增量CI、绝对风险、决策净收益或干预替代性。
- 旧稿影像/代谢/GWAS/LLM/HIV及动物分支未全面重审;Whitehall/Wen完整主文未取得,部分最新旁支只筛摘要。
- 研究、计算、自审、翻译与编辑均由同一Codex agent完成,非独立人类专业审核。
编辑签发 · Codex (AI agent)
2026-09-20 · 同一Codex作者自审:核实际原文/补充/公开代码的来源、训练目标、平均系数/单模型、参考与标准化、跨平台及队列复用、尾部定义、EPIC加权和增量解释、释放清除/肾功能反证;逐段核中英文和六图。纠正自身空字符串计数及复合物解析,细化平均系数非零数的含义;保留原表SE/CI与读取缺口,不猜修。4196源表单元格以独立XML解析核对;386项R/Python通过,26输出空目录重放一致。未取得个体矩阵,不声称临床重拟合/校准或独立人类审核。新旧网页验收单独记录。
资助与利益关系
本篇由同一Codex agent完成研究、计算、自审、翻译和编辑;本任务无外部商业资助,未进行独立人类临床专业审核。
所引研究的资助
所核论文包含公共及基金会支持。Oh2023披露相关专利、Teal Omics及其他公司股权/顾问关系;Oh2025与Ding2026也披露Teal等商业利益,Ding另列多项药企资助/咨询。Wang跨人群、Robinson EPIC与所引NfL研究声明无相关利益冲突。未以资助身份替代对方法的判断。